این سرویس چیست؟
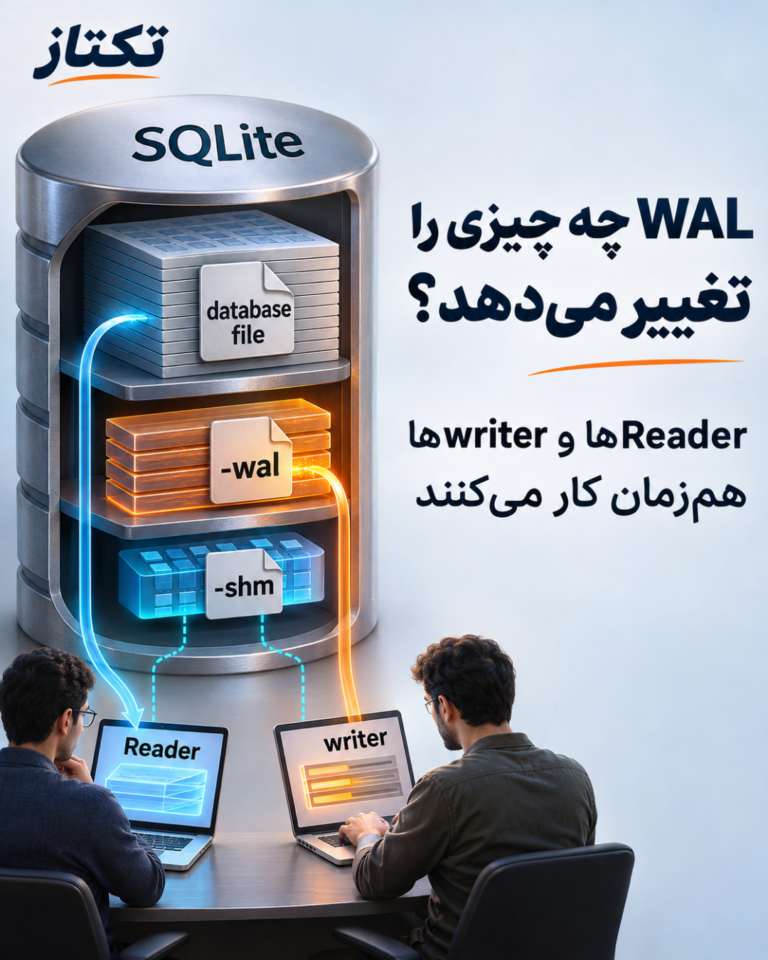
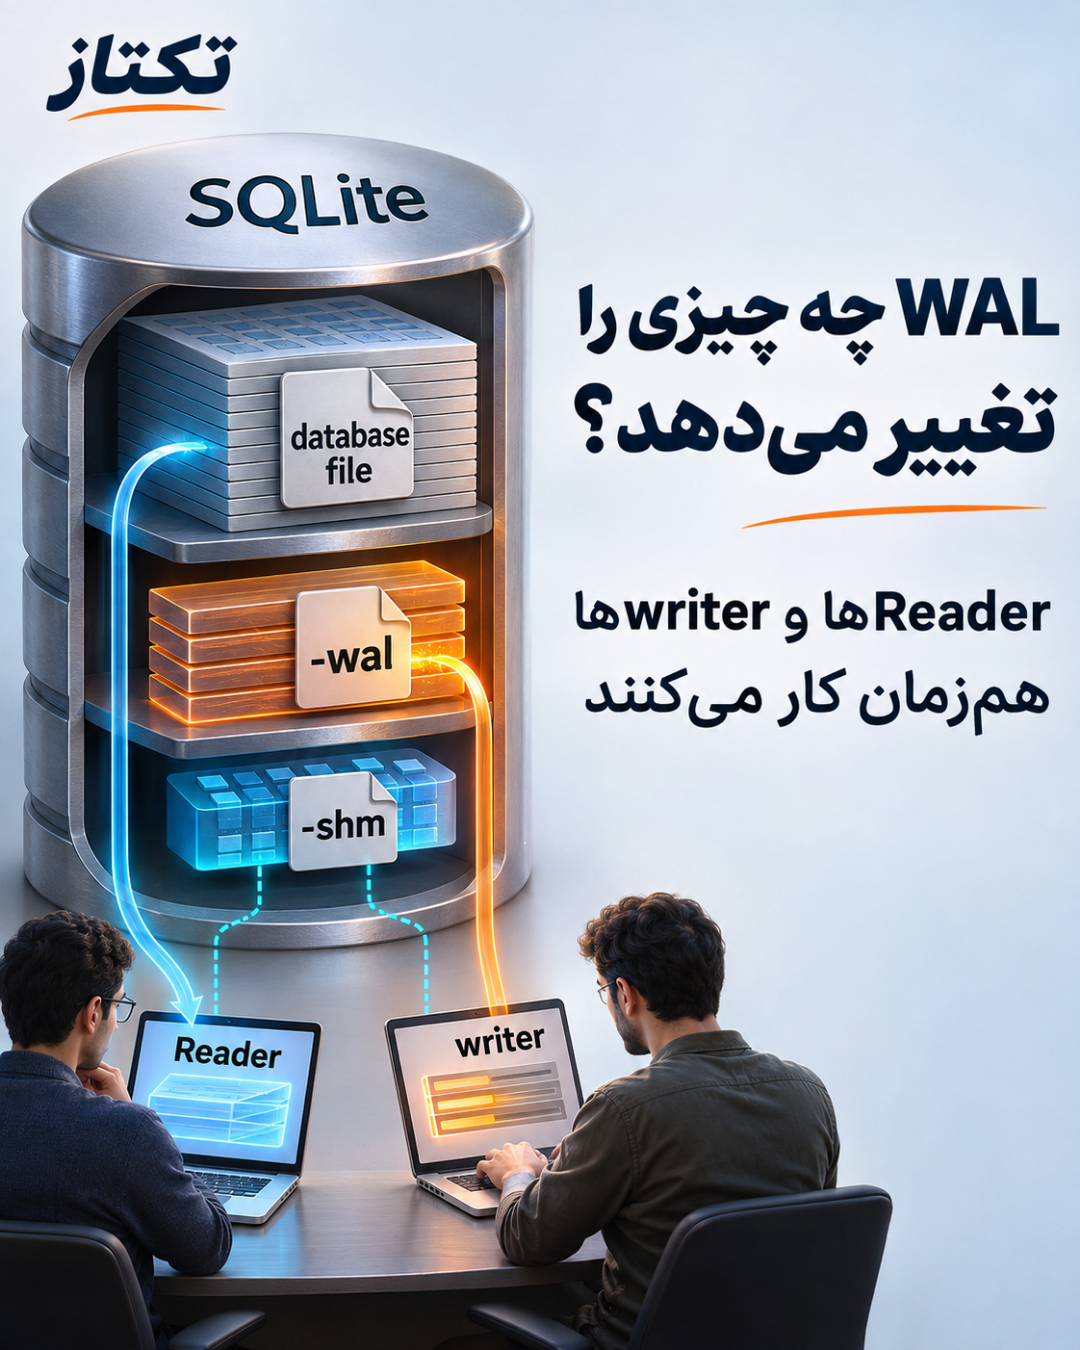
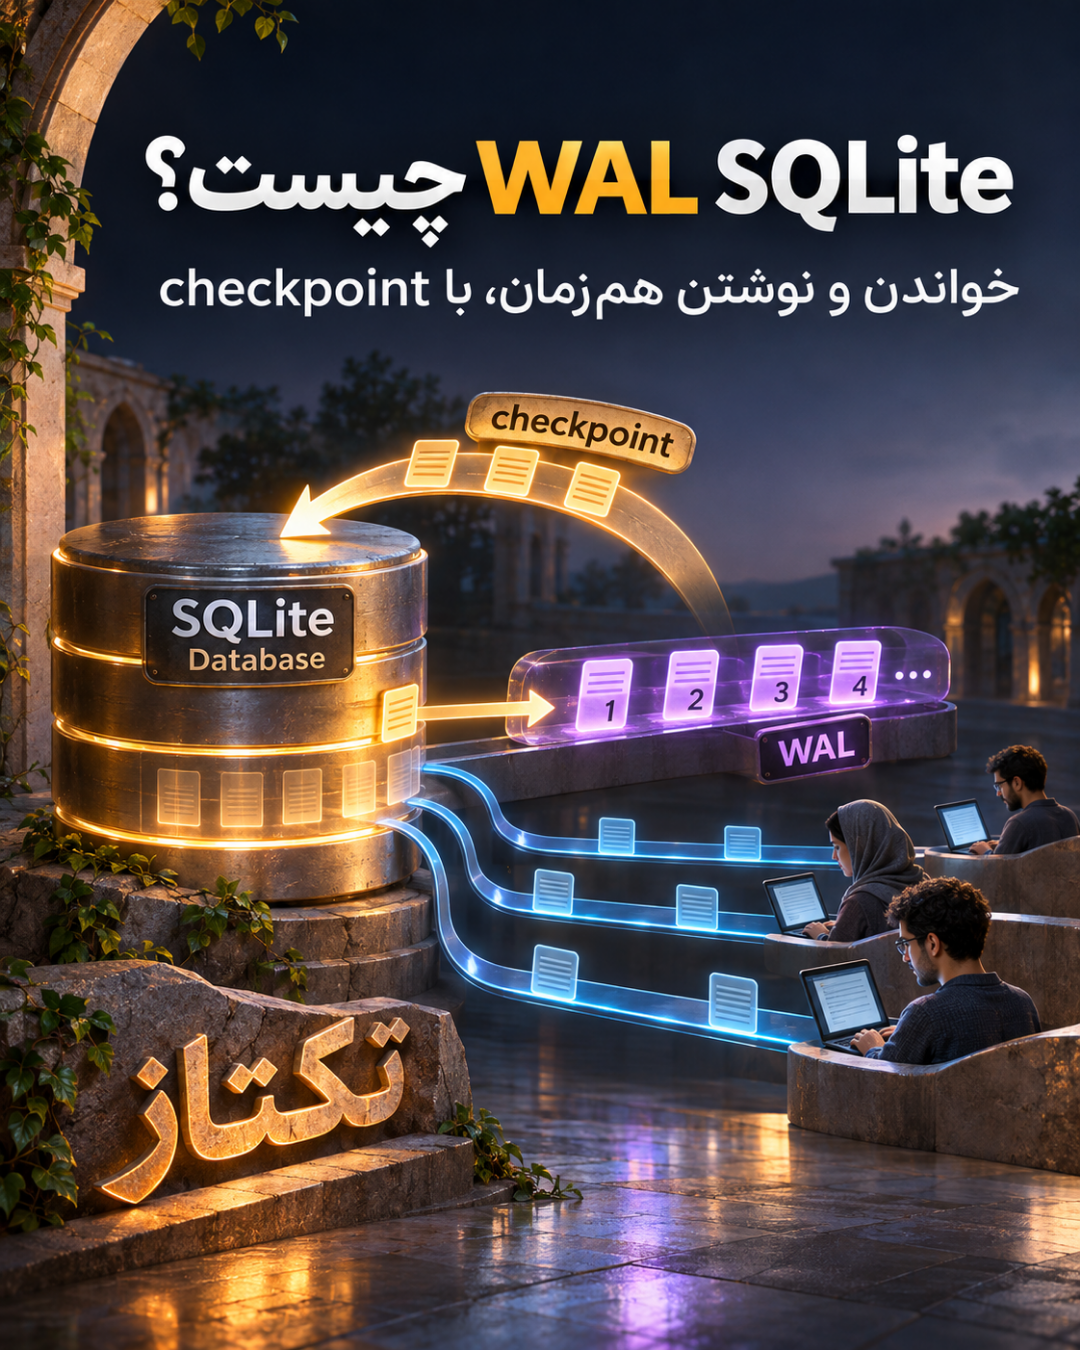
SQLite یک موتور دیتابیس سبک و درونبرنامهای است که برای بسیاری از اپلیکیشنها، ابزارهای دسکتاپ و سرویسهای کوچک بدون سرور جداگانه کار میکند. حالت WAL یا Write-Ahead Logging روش ثبت تغییرات SQLite را عوض میکند تا readerها و writerها بتوانند در بسیاری از سناریوها همزمان کار کنند. این حالت یک فایل -wal و معمولاً یک فایل -shm کنار دیتابیس ایجاد میکند و برای خالیکردن تدریجی تغییرات به checkpoint نیاز دارد.
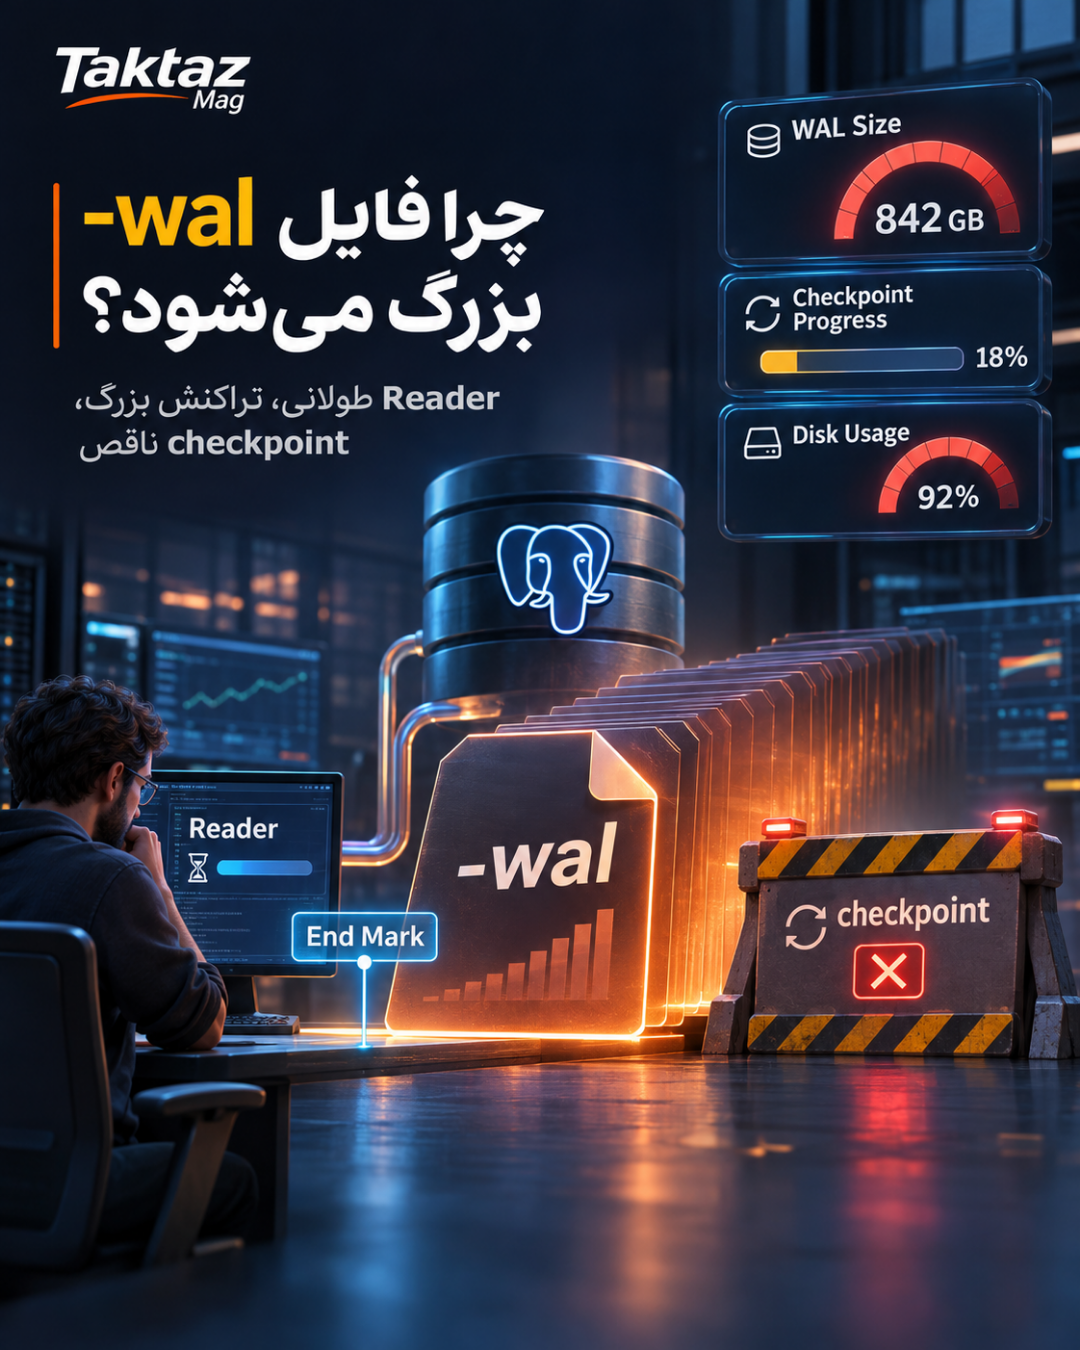
WAL برای معماریای مناسب است که همهٔ processها روی یک میزبان باشند و workload آن تراکنشهای کوچک و متعادل داشته باشد. اگر reader طولانی باز بماند یا تراکنشهای بزرگ اجرا شوند، checkpoint نمیتواند بهطور کامل جلو برود؛ در نتیجه فایل WAL بزرگ میشود، خواندن کندتر میشود و مصرف دیسک بالا میرود. این راهنما کمک میکند WAL را با اندازهگیری و کنترل فعال کنید، نه با یک تغییر کورکورانه در production.
مزیتهای WAL و محدودیتهای مهم
در journal معمولی، SQLite تغییرات را در rollback journal مینویسد و سپس دیتابیس اصلی را تغییر میدهد. در WAL، تغییرات ابتدا به انتهای فایل WAL اضافه میشوند و commit بدون بازنویسی فوری فایل اصلی انجام میشود. همین رفتار باعث میشود readerها از snapshot خود بخوانند و writer در بسیاری از وضعیتها آنها را متوقف نکند. WAL همچنین در workloadهای متداول میتواند I/O ترتیبیتری داشته باشد.
اما WAL یک راهحل عمومی برای همهٔ معماریها نیست. همهٔ processهای استفادهکننده باید روی همان host باشند؛ مستندات رسمی SQLite صریحاً میگوید WAL روی network filesystem کار نمیکند، چون readerها و writerها به shared memory برای wal-index نیاز دارند. علاوه بر این، در هر لحظه فقط یک writer میتواند به فایل WAL اضافه کند. تراکنشهای بسیار بزرگ هم میتوانند checkpoint و مصرف دیسک را تحت فشار قرار دهند.
پیش از فعالسازی، اندازهٔ فایل اصلی، -wal و -shm، محل ذخیرهسازی، تعداد connectionها و الگوی خواندن و نوشتن را ثبت کنید. برای نکات عمومی نگهداری سرویسهای لینوکس، راهنمای سختسازی سرویسهای لینوکس را نیز ببینید.
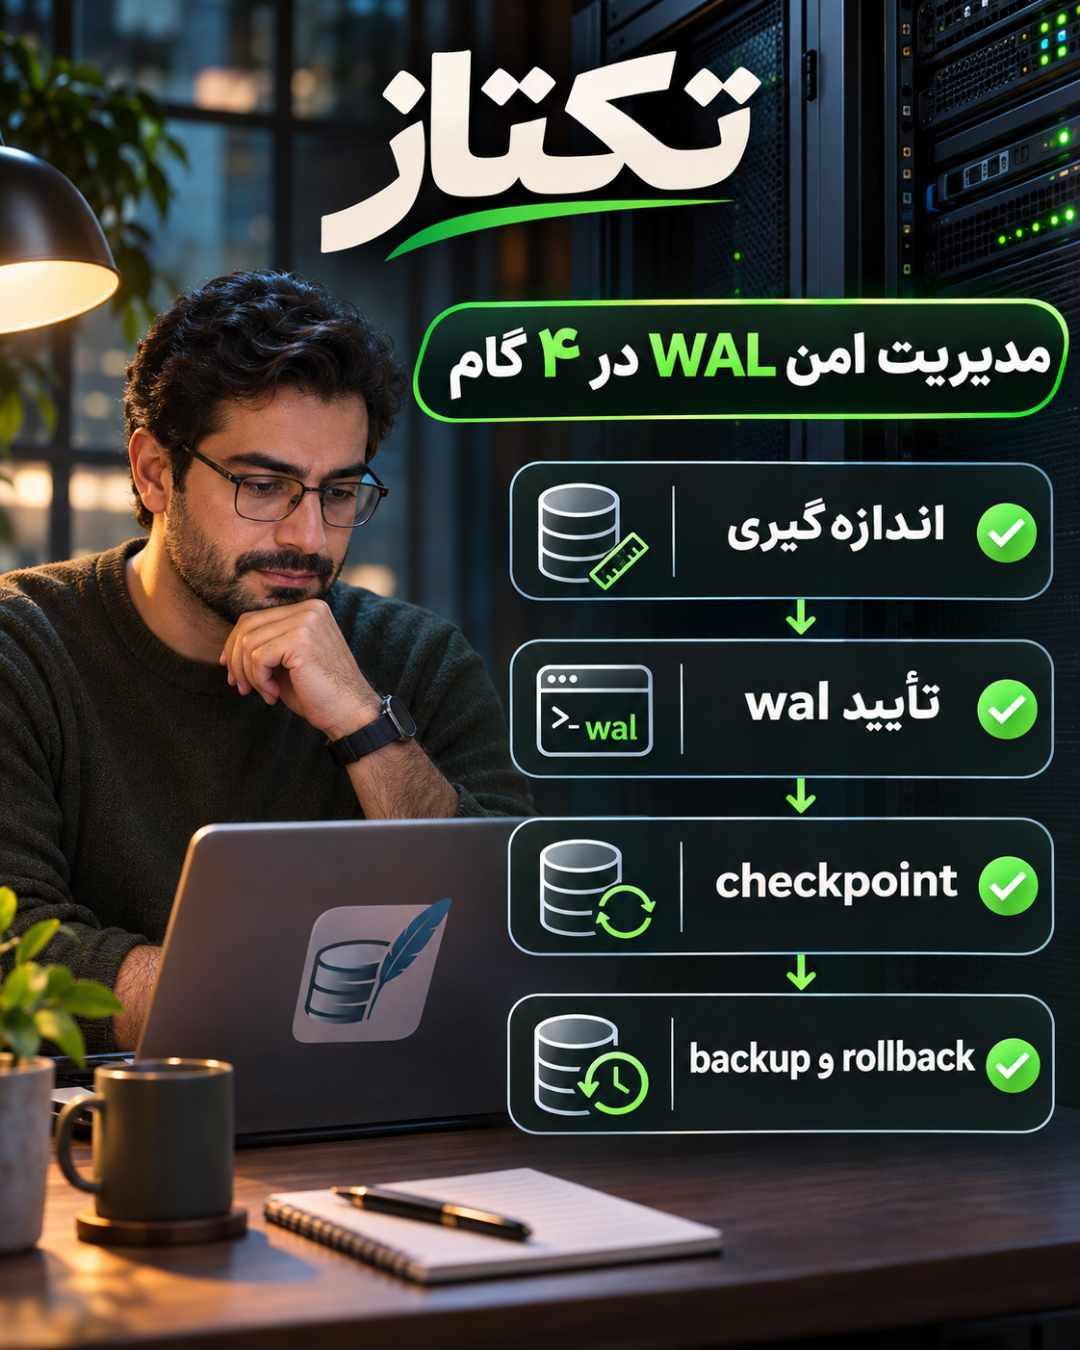
گام ۱: وضعیت فعلی را اندازه بگیرید
در staging یک کپی از دیتابیس بسازید و قبل از تغییر، حجم database، database-wal و database-shm را در چند بازهٔ زمانی ثبت کنید. همزمان زمان commit، طولانیترین read transaction و تعداد connectionهای باز را اندازه بگیرید. اگر فایل WAL فقط هنگام یک عملیات خاص رشد میکند، بهدنبال همان تراکنش یا reader بگردید؛ اگر در تمام ساعات رشد دارد، احتمال checkpoint starvation یا نبودن checkpoint مؤثر بیشتر است.
محل فایل را هم بررسی کنید. اگر دیتابیس روی NFS، SMB یا یک network filesystem است، فعالکردن WAL میتواند به خطا یا رفتار غیرقابلپیشبینی منجر شود. همهٔ processها باید روی یک host و با دسترسی سازگار به فایل اصلی و فایلهای جانبی باشند
. این گیت معماری را قبل از هر tuning انجام دهید.
گام ۲: WAL را آگاهانه فعال و تأیید کنید
در یک connection آزمایشی، PRAGMA journal_mode=WAL; را اجرا کنید. SQLite باید مقدار wal را برگرداند؛ اگر مقدار قبلی مانند delete برگردد، تبدیل کامل نشده است و نباید ادامهٔ راهنما را موفق فرض کنید. مقدار برگشتی را در لاگ deployment ثبت کنید و مطمئن شوید تمام processهای برنامه همان فایل را میبینند.
پس از فعالسازی، یک reader و writer کنترلشده اجرا کنید و زمان commit، زمان query و اندازهٔ WAL را بسنجید. WAL بهمعنای حذف قفل یا بینهایتشدن همزمانی نیست؛ یک writer همچنان محدودیت دارد و transactionهای بزرگ میتوانند latency را بالا ببرند. تراکنشهای بزرگ را تا جای ممکن به بخشهای کوچکتر تقسیم کنید و connectionهای معطل را سریع ببندید.
گام ۳: checkpoint و رشد WAL را پایش کنید
SQLite بهطور پیشفرض وقتی WAL به حدود ۱۰۰۰ page برسد checkpoint خودکار اجرا میکند. مقدار wal_autocheckpoint و رفتار واقعی workload را ثبت کنید؛ عدد پیشفرض برای همهٔ برنامهها بهینه نیست. اجرای PRAGMA wal_checkpoint(PASSIVE); در محیط تست اطلاعاتی دربارهٔ پیشرفت checkpoint میدهد، بدون اینکه readerها را مجبور به توقف کند. حالتهای FULL و RESTART را فقط با شناخت اثرشان روی latency و connectionها امتحان کنید.
یک reader طولانی میتواند checkpoint را پشت end mark خودش نگه دارد. اگر checkpoint مرتباً تا یک نقطه پیش میرود اما WAL کوچک نمیشود، طول عمر transactionهای خواندنی و connection pool را بررسی کنید. پایش باید اندازهٔ WAL، زمان آخرین checkpoint، خطاهای دیسک و تعداد transactionهای طولانی را ثبت کند. alert را بر اساس رشد پایدار و ظرفیت واقعی دیسک تنظیم کنید، نه فقط یک جهش کوتاه.
گام ۴: دوام، rollback و تست production-like
تنظیم synchronous بین دوام پس از قطع برق و کارایی تعادل ایجاد میکند. تغییر این مقدار را بدون تست crash و backup verification انجام ندهید. پیش از rollout، از دیتابیس نسخهٔ پشتیبان بگیرید، restore را واقعاً امتحان کنید و مسیر برگشت به rollback journal را مستند کنید. journal mode قبلی را فقط پس از بستن connectionهای مربوط و طبق روش سازگار با برنامه تغییر دهید.
سناریوی production-like برای SQLite باید reader طولانی، writer همزمان، transaction بزرگ، قطع و وصل کنترلشده و پرشدن نزدیک ظرفیت دیسک را پوشش دهد. در هر مرحله زمان query، زمان commit، حجم WAL و سلامت backup را مقایسه کنید. اگر WAL روی محیط واقعی بهصورت پیوسته رشد میکند، صرفاً آستانهٔ autocheckpoint را بالا نبرید؛ اول علت توقف checkpoint را پیدا کنید.
جمعبندی
WAL میتواند همزمانی خواندن و نوشتن SQLite را بهتر کند، اما checkpoint بخش جداییناپذیر طراحی آن است. reader طولانی، transaction بزرگ، connection معطل و network filesystem چهار ریسک مهماند. با ثبت اندازهٔ فایلها، تأیید مقدار برگشتی journal_mode، آزمون حالتهای checkpoint، پایش رشد WAL و داشتن backup و rollback واقعی، میتوان از مزیت WAL استفاده کرد بدون اینکه مصرف دیسک و latency پنهانی به بحران تبدیل شود.
منبع اصلی: مستندات رسمی SQLite دربارهٔ Write-Ahead Logging
مطالب مرتبط
همه مطالب مقالات آموزشی مقالات آموزشیPolarDB Agentic Database عمومی شد؛ دیتابیس برای نسل جدید Agentها
- مقالات آموزشیآموزش EXPLAIN در PostgreSQL؛ ۷ گام برای پیدا کردن کوئریهای کند
- مقالات آموزشیحذف secretهای بلندمدت از GitHub Actions با OIDC
- مقالات آموزشیOpenStack Hibiscus ۲۰۲۶.۲؛ امنیت و زیرساخت آمادهٔ AI
- مقالات آموزشی.NET ۱۱ منتشر شد؛ راهنمای تصمیمگیری برای ارتقای تیمهای توسعه
- مقالات آموزشیPostgreSQL ۱۸.۷ منتشر شد؛ راهنمای بهروزرسانی امن نسخههای پایدار