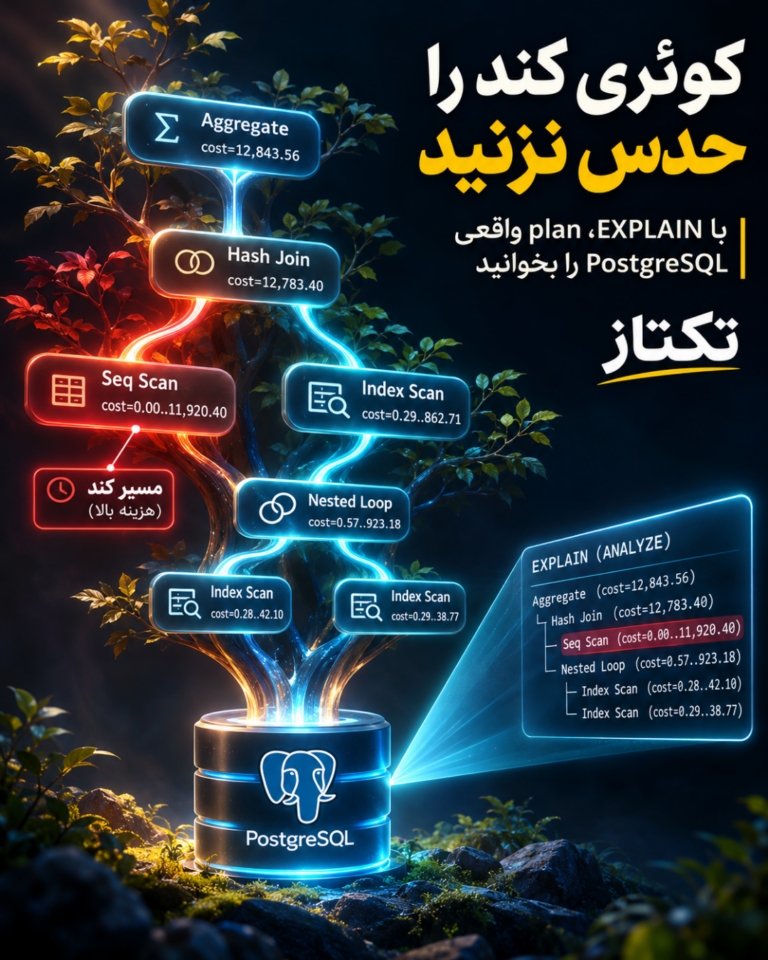
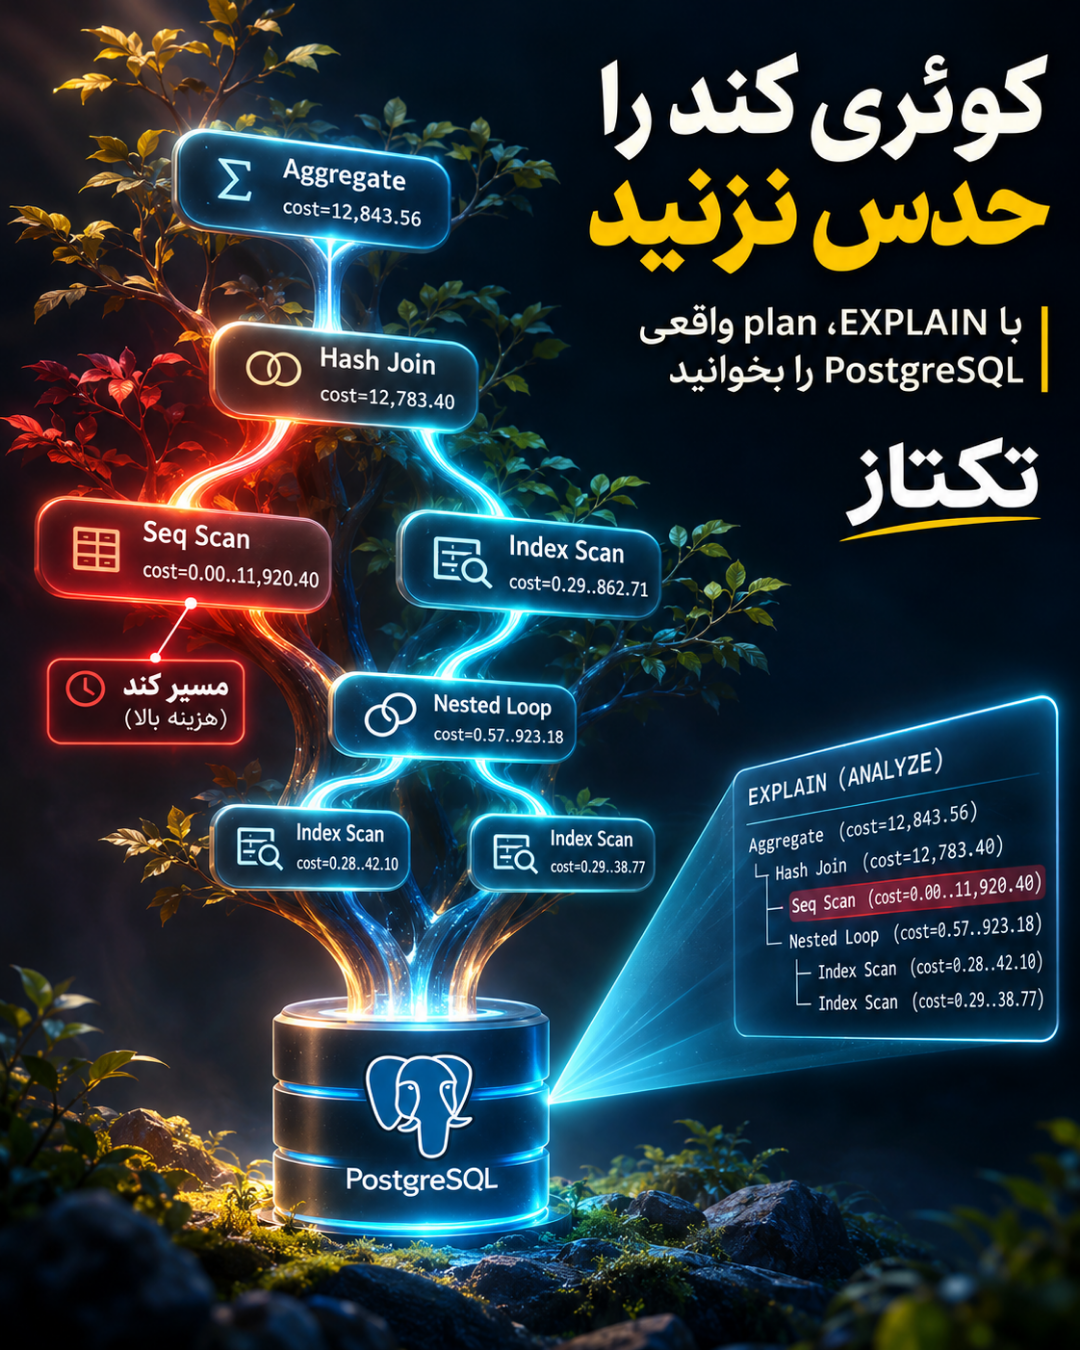
EXPLAIN در PostgreSQL ابزاری برای دیدن نقشهٔ اجرای کوئری و مقایسهٔ تخمین planner با رفتار واقعی است. این نقشه نشان میدهد دادهها از کدام scan خوانده میشوند، join و sort چگونه انجام میگیرند و هزینه و تعداد ردیف تخمینی هر مرحله چقدر است. به همین دلیل، حل کندی کوئری PostgreSQL نباید با حدسزدن یا اضافهکردن فوری ایندکس شروع شود؛ ابتدا باید plan واقعی را خواند و تفاوت تخمین planner با اجرای واقعی را اندازه گرفت.
در این راهنما یک مسیر قابل تکرار برای عیبیابی میسازیم. هدف این نیست که هر Seq Scan را بد بدانیم یا هر Index Scan را خوب فرض کنیم. یک Seq Scan روی جدول کوچک میتواند بهترین انتخاب باشد، درحالیکه ایندکس نامناسب روی جدولی بزرگ ممکن است فقط هزینهٔ نگهداری و نوشتن را زیاد کند. مستندات رسمی PostgreSQL نیز تأکید میکند که انتخاب plan به ساختار کوئری و ویژگیهای داده وابسته است.
۱. زمان پایه را بدون حدس ثبت کنید
پیش از تغییر کوئری یا schema، همان درخواست را با داده و شرایط نزدیک به production اجرا کنید. تعداد ردیف خروجی، زمان پاسخ، پارامترهای واقعی و وضعیت cache را ثبت کنید. اگر benchmark قابل تکرار نباشد، بعداً نمیتوان فهمید بهبود از تغییر plan آمده یا از گرمشدن cache و تفاوت بار سیستم.
۲. با EXPLAIN درخت plan را بخوانید
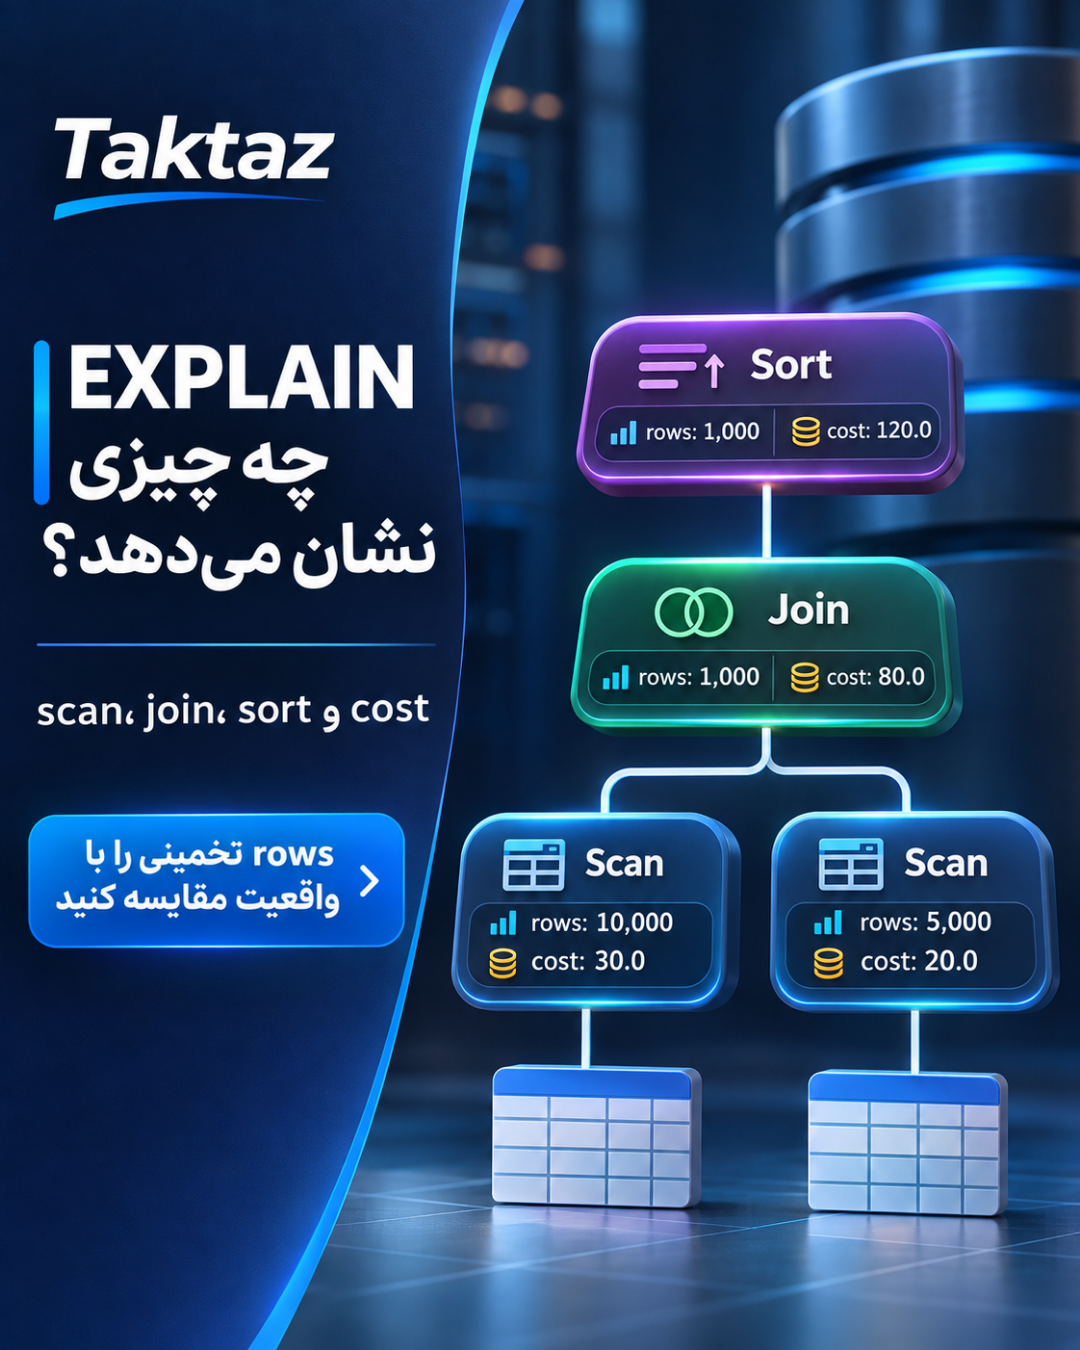
با EXPLAIN فقط نقشهٔ اجرای کوئری نمایش داده میشود و خود کوئری اجرا نمیشود. خروجی یک درخت است؛ گرههای پایین معمولاً scan جدول یا index هستند و گرههای بالاتر join، sort، aggregate یا filter را انجام میدهند. برای هر گره به نوع عملیات، cost، rows و width نگاه کنید. cost زمان واقعی نیست و واحد آن به پارامترهای planner وابسته است، اما برای مقایسهٔ planها مفید است.
۳. تخمین rows را با واقعیت مقایسه کنید
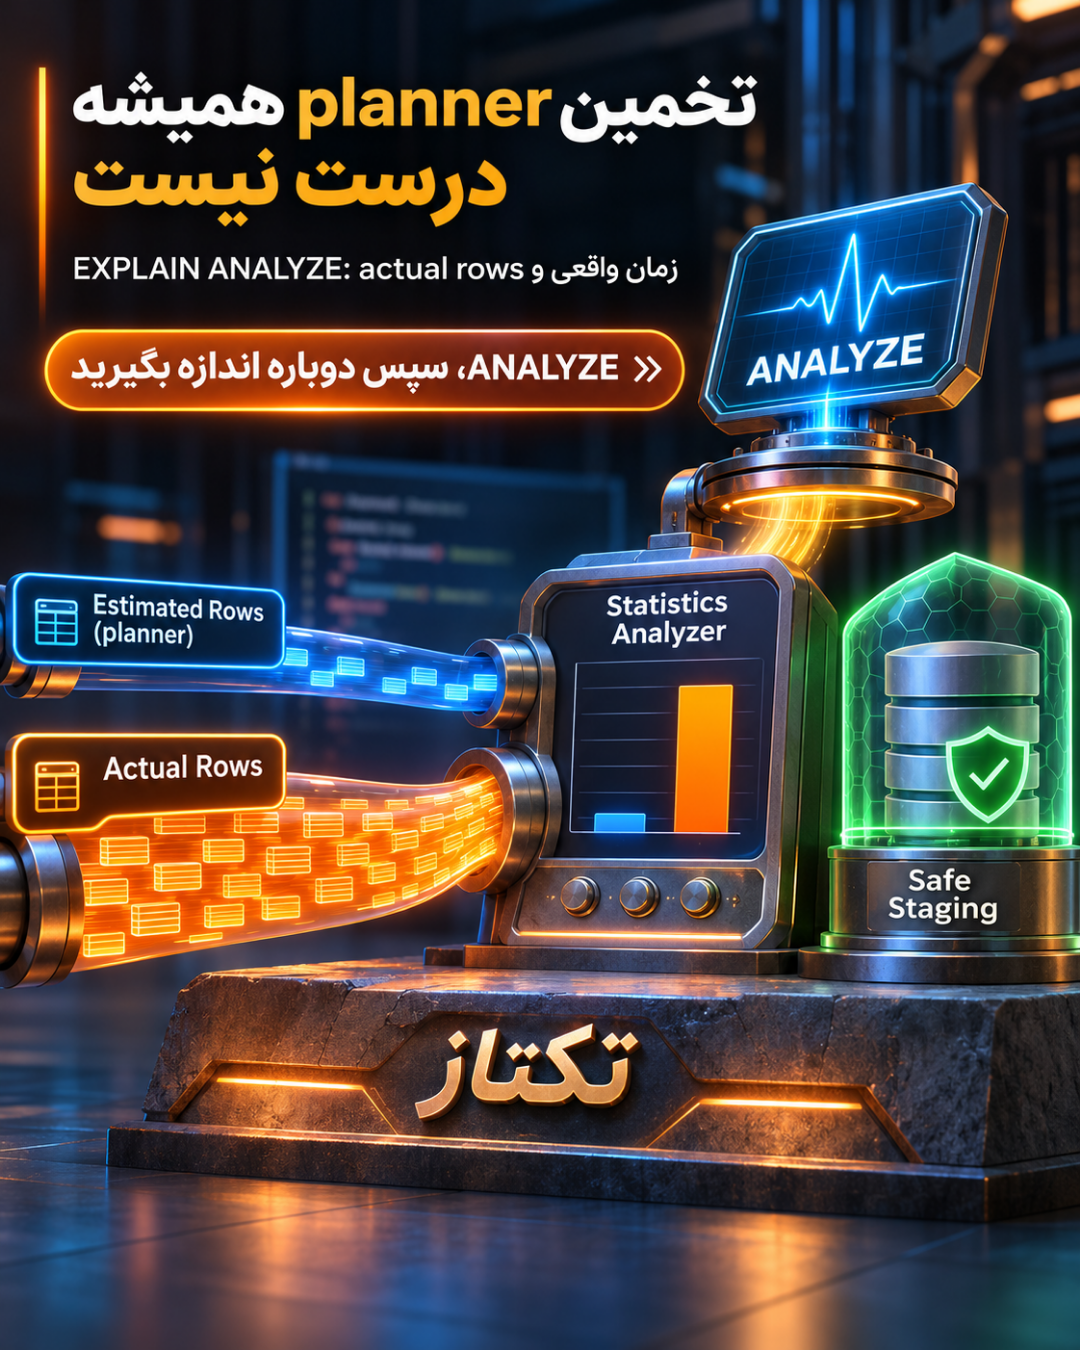
تفاوت بزرگ بین rows تخمینی و تعداد ردیف واقعی یکی از سرنخهای اصلی است. اگر planner انتظار چند ردیف دارد اما در عمل میلیونها ردیف از یک گره عبور میکند، ممکن است statistics قدیمی باشد یا توزیع داده با فرض planner سازگار نباشد. در این وضعیت، پیش از تغییر عجولانهٔ ایندکس، ستونهای شرط و مقدارهای پرتکرار را بررسی کنید.
۴. EXPLAIN ANALYZE را با احتیاط اجرا کنید
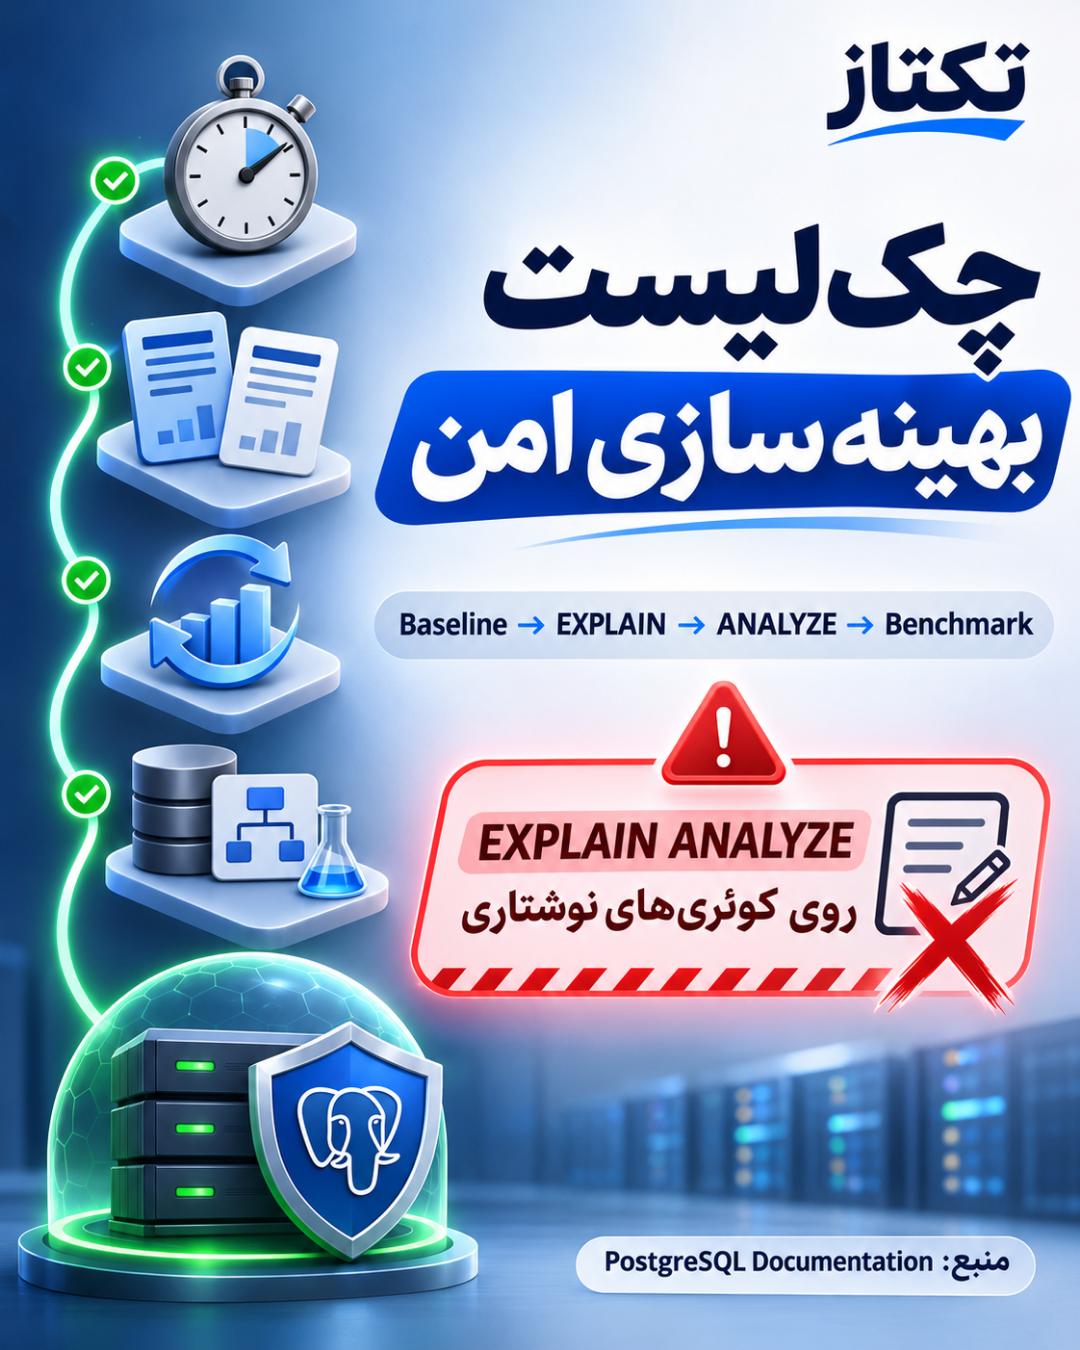
EXPLAIN ANALYZE کوئری را واقعاً اجرا میکند و actual time، actual rows و loops را کنار تخمینها نشان میدهد. این ابزار برای اعتبارسنجی بسیار ارزشمند است، اما روی UPDATE، DELETE یا دستورهای دارای side effect میتواند تغییر واقعی ایجاد کند. برای چنین دستورهایی از transaction آزمایشی یا محیط staging استفاده کنید و خروجی JSON را برای تحلیل ماشینی ذخیره کنید.
۵. Seq Scan و Index Scan را در زمینهٔ داده ببینید
Seq Scan الزاماً مشکل نیست؛ اگر بخش بزرگی از جدول باید خوانده شود، خواندن ترتیبی میتواند از رفتوآمد تصادفی به index سریعتر باشد. Index Scan برای انتخابپذیری بالا و خروجی کوچک مفید است، اما هزینهٔ fetch ردیف از heap و ترتیب موردنیاز ORDER BY را هم باید در نظر گرفت. در joinها نیز Nested Loop، Hash Join و Merge Join هرکدام برای شکل متفاوتی از داده مناسباند.
۶. statistics را تازه کنید و دوباره اندازه بگیرید
اگر اختلاف تخمین شدید است، ANALYZE هدفمند روی جدول یا ستونهای درگیر اجرا کنید و plan را دوباره بخوانید. افزایش بیدلیل default_statistics_target راهحل عمومی نیست؛ ابتدا مشخص کنید کدام ستون و کدام الگوی داده به histogram یا تعداد نمونهٔ دقیقتر نیاز دارد. پس از هر تغییر، زمان planning، زمان execution، buffers و تعداد ردیفها را با baseline مقایسه کنید.
۷. ایندکس یا بازنویسی را با benchmark کنترلشده بسنجید
ایندکس مرکب باید با ترتیب شرطها، sort و selectivity واقعی سازگار باشد. ساختن چند ایندکس مشابه، write را کند و حجم backup را بیشتر میکند. اگر plan هنوز پرهزینه است، predicate، join condition و مقدار دادهٔ برگشتی را بازبینی کنید؛ گاهی بازنویسی کوئری یا محدودکردن ستونهای SELECT از افزودن ایندکس جدید مؤثرتر است. هر تغییر را جداگانه در staging آزمایش کنید و نتیجه را با همان ورودی قبلی بسنجید.
چکلیست کوتاه برای production
در production فقط خروجی یک اجرای موفق را معیار نگیرید. plan را برای پارامترهای پرتکرار و کمتکرار بررسی کنید، تغییرات statistics را پایش کنید و زمان planning و execution را جداگانه در لاگ یا ابزار observability ثبت کنید. در صورت تغییر شدید حجم جدول، baseline را بهروزرسانی کنید. برای آموزشهای فنی بیشتر میتوانید به مجلهٔ تکتاز مراجعه کنید و برای جزئیات syntax و نمونههای رسمی، مستندات PostgreSQL دربارهٔ EXPLAIN را بخوانید.
جمعبندی
مسیر امن عیبیابی کوئری کند PostgreSQL از اندازهگیری شروع میشود: baseline، EXPLAIN، مقایسهٔ estimated و actual، بررسی statistics و سپس آزمایش کنترلشدهٔ ایندکس یا بازنویسی. با این روش، بهجای درمان حدسی، علت plan پرهزینه را پیدا میکنید و ریسک ایجاد ایندکسهای بیاثر یا اجرای ناخواستهٔ دستورهای تغییردهنده را کاهش میدهید.
مطالب مرتبط
همه مطالب مقالات آموزشی مقالات آموزشیOpenStack Hibiscus ۲۰۲۶.۲؛ امنیت و زیرساخت آمادهٔ AI
- مقالات آموزشیراهنمای ۲۰۲۶ بازبینی کد Copilot با API
- مقالات آموزشیحذف secretهای بلندمدت از GitHub Actions با OIDC
- مقالات آموزشیWindows ۱۱؛ آپدیت اکتبر و تفاوت 26H1 و 26H2 برای مدیران
- مقالات آموزشیKali Linux ۲۰۲۶.۳؛ ساخت ایمیج سفارشی با Docker و Podman
- مقالات آموزشیآموزش بخش دیدگاه ها در وردپرس