اتوماسیون مقاوم در n8n یعنی طراحی workflowهایی که سرویسها و ابزارها را به هم متصل میکنند و در برابر خطا، timeout و دادهٔ ناقص رفتار قابلپیشبینی دارند. n8n یک پلتفرم ساخت workflowهای اتوماسیون است؛ این راهنما نشان میدهد چگونه در آن خطاها را مدیریت کنیم و از اجرای تکراری عملیات حساس جلوگیری کنیم. هدف اتوماسیون مقاوم در n8n این است که شکست، قابلتشخیص و قابلبازیابی باشد.
اگر همزمان روی امنیت و نگهداری سایت کار میکنید، راهنمای امنیت وردپرس را هم ببینید؛ این دو موضوع در کنترل ریسک سرویسهای آنلاین مکمل یکدیگرند.
چرا خطا در اتوماسیون خطرناک است؟
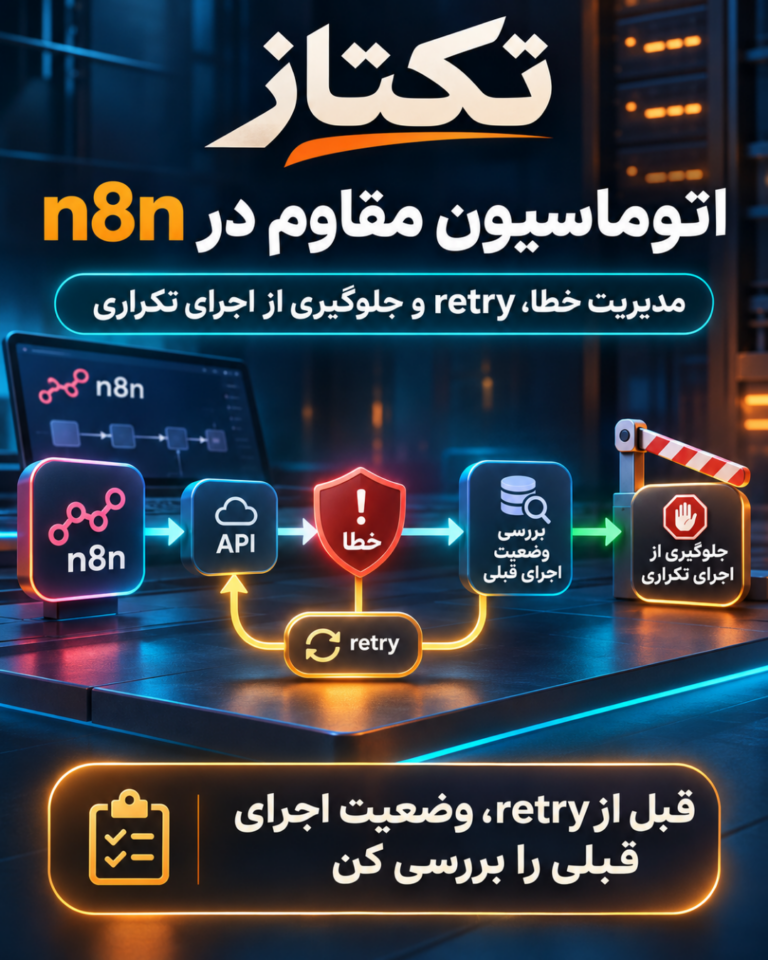
در یک سناریوی ساده، خطای موقت شاید فقط باعث توقف یک اجرا شود. اما اگر workflow بخشی از عملیات را انجام داده باشد و سپس timeout بگیرد، retry کور میتواند پیام را دوباره بفرستد، سفارش را دوباره ثبت کند یا یک عملیات حساس را دو بار انجام دهد. بنابراین پیش از هر retry باید مشخص شود خطا موقت است یا دائمی و آیا نتیجهای از اجرای قبلی باقی مانده است.
ساخت Error Workflow مرکزی
در اتوماسیون مقاوم در n8n، Error Workflow باید بخشی از طراحی اولیه باشد، نه وصلهای که بعد از اولین خطا اضافه شود.
در n8n میتوان یک workflow جداگانه با node نوع Error Trigger ساخت و آن را از بخش Workflow Settings به چند workflow متصل کرد. طبق مستندات رسمی n8n، این جریان هنگام شکست execution اجرا میشود و میتواند اعلان ایمیلی، پیام Slack یا ثبت در یک سیستم مانیتورینگ را انجام دهد. داشتن یک Error Workflow مرکزی باعث میشود خطاها در یک قالب واحد گزارش شوند و تیم مجبور نباشد هر workflow را جداگانه رصد کند.
گزارش خطا باید دستکم نام workflow، شناسه execution، لینک execution در صورت ذخیرهشدن، نام آخرین node اجراشده، متن خطا و زمان رخداد را داشته باشد. اگر خطا در trigger اصلی رخ دهد، ساختار داده متفاوت است و ممکن است جزئیات execution کامل نباشد؛ این حالت باید در parser اعلان هم در نظر گرفته شود.
تفکیک خطای موقت از خطای دائمی
خطاهای شبکه، timeout کوتاهمدت یا پاسخهای موقت سرویس معمولاً نامزد retry هستند؛ در مقابل، خطای احراز هویت، دادهٔ نامعتبر، نبودن دسترسی یا خطای منطقی نباید بدون اصلاح دوباره تکرار شود. برای هر node مهم، نوع خطا و واکنش مجاز را مشخص کنید:
- خطای موقت: چند تلاش محدود با فاصلهٔ افزایشی و ثبت هر تلاش.
- خطای دائمی: توقف جریان، ثبت جزئیات و ارسال اعلان قابلپیگیری.
- دادهٔ ناقص: اعتبارسنجی پیش از عملیات و استفاده از Stop And Error با پیام روشن.
Retry کنترلشده، نه retry کور
تعداد retry باید محدود باشد و بین تلاشها از Wait یا backoff استفاده شود. در هر retry، شناسهٔ اجرای اصلی و شمارهٔ تلاش را ثبت کنید تا مشخص باشد کدام رخداد در حال تکرار است. اگر سرویس مقصد کدهایی مانند ۴۲۹ یا ۵۰۳ برگرداند، میتوان تلاش بعدی را با فاصلهٔ بیشتر انجام داد؛ اما برای خطاهای ۴۰۱ یا ۴۰۳، تکرار درخواست معمولاً فایدهای ندارد و باید دسترسی یا اعتبارنامه بررسی شود.
کلید idempotency برای جلوگیری از تکرار
هر عملیاتی که اثر بیرونی دارد—مانند ارسال پیام، ساخت سفارش، ثبت پرداخت یا ایجاد تیکت—باید یک idempotency key داشته باشد. این کلید میتواند از شناسهٔ رویداد، نوع عملیات و نسخهٔ داده ساخته شود. پیش از اجرای دوباره، workflow باید در مقصد یا یک storage قابلاعتماد جستوجو کند: اگر همان کلید قبلاً با موفقیت ثبت شده، عملیات دوباره انجام نشود؛ اگر وضعیت نامشخص است، ابتدا وضعیت قبلی خوانده و سپس تصمیمگیری شود.
تست سناریوهای شکست
پیش از انتقال workflow به production، timeout، پاسخ نامعتبر، قطعی سرویس، اجرای دوبارهٔ یک event و خطای trigger را شبیهسازی کنید. مستندات n8n همچنین node به نام Stop And Error را برای ایجاد خطای عمدی در شرایط انتخابی معرفی میکند؛ این node برای تست مسیر اعلان و بررسی رفتار Error Workflow مفید است.
چکلیست نهایی
- برای workflowهای مهم Error Workflow مرکزی و اعلان قابلردگیری تعریف کنید.
- نام workflow، execution id، آخرین node و متن خطا را ثبت کنید.
- خطاهای موقت و دائمی را از هم جدا کنید و retry را محدود نگه دارید.
- برای عملیات اثرگذار idempotency key و بررسی وضعیت قبلی بسازید.
- قبل از انتشار، timeout، پاسخ نامعتبر، retry و rollback را در staging تست کنید.
برای پیادهسازی اتوماسیون مقاوم در n8n، ابتدا مسیرهای شکست را روی staging ثبت کنید و سپس برای هر مسیر یک واکنش مشخص بنویسید. این رویکرد کمک میکند اتوماسیون مقاوم در n8n به مجموعهای از retryهای تصادفی تبدیل نشود.
معیار موفقیت اتوماسیون مقاوم در n8n فقط اجرای بدون خطا نیست؛ امکان مشاهده، بازیابی و جلوگیری از اثر تکراری هم باید سنجیده شود.
در نهایت، اتوماسیون مقاوم در n8n یعنی هر شکست، قابلفهم و قابلبازیابی باشد؛ نه اینکه با retry بیحساب، اثرهای تکراری و هزینههای پنهان بسازد. برای جزئیات Error Trigger و دادهٔ ارسالی به Error Workflow، مستندات رسمی n8n را ببینید. با همین الگو میتوان اتوماسیون مقاوم در n8n را مرحلهبهمرحله توسعه داد.
مطالب مرتبط
همه مطالب مقالات آموزشی مقالات آموزشیPolarDB Agentic Database عمومی شد؛ دیتابیس برای نسل جدید Agentها
- مقالات آموزشیOpenStack Hibiscus ۲۰۲۶.۲؛ امنیت و زیرساخت آمادهٔ AI
- مقالات آموزشیراهنمای ۲۰۲۶ بازبینی کد Copilot با API
- مقالات آموزشیWindows ۱۱؛ آپدیت اکتبر و تفاوت 26H1 و 26H2 برای مدیران
- مقالات آموزشیAndroid Studio Rabbit ۲ و نسل تازهٔ توسعهٔ عاملمحور اندروید
- مقالات آموزشیآموزش EXPLAIN در PostgreSQL؛ ۷ گام برای پیدا کردن کوئریهای کند